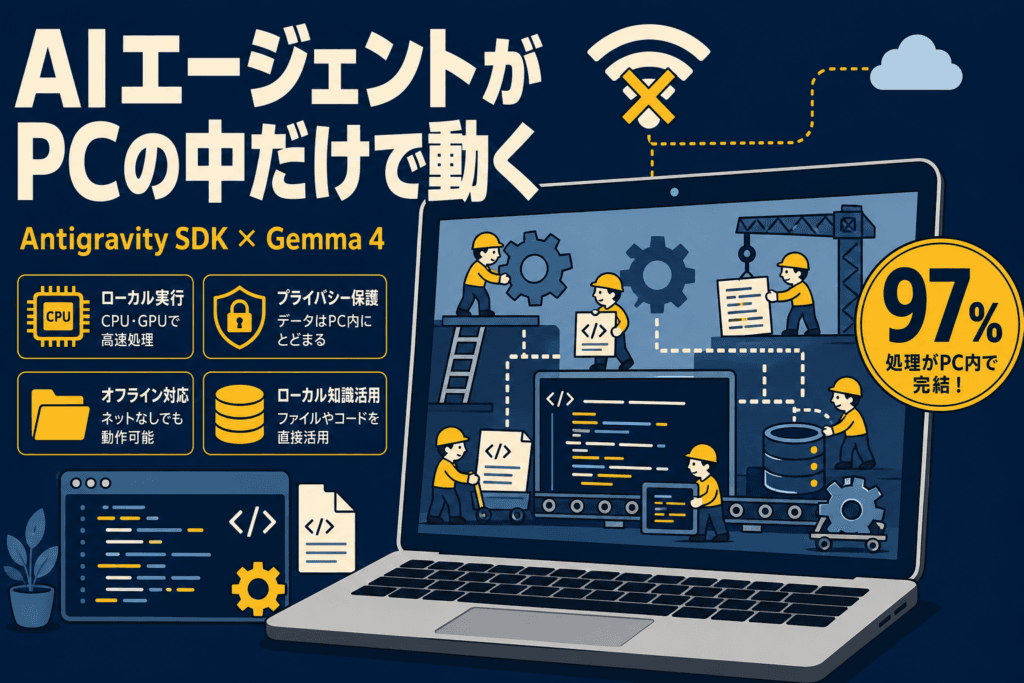
- Googleが2026年9月23日、Antigravity SDKでローカルAIモデルを使えるようにしました
- 最初の対応モデルは「Gemma 4 26B A4B」。ネットなしでもAIエージェントが動きます
- Ollama・LM Studio・vLLMといった定番ツールともつながります
- 公式デモでは処理の97.2%をPCの中だけで完了し、クラウド利用は95トークンだけでした
- 必要なのは24GB以上のメモリ。手元のPCで動くかどうかが最初の関門です
AIエージェントに仕事を任せたいけど、API代がかさむのが怖い。社外にコードを出したくない。そんな悩みを抱えていませんか?Googleの開発者向けツール「Antigravity SDK」が、自分のPCの中だけでAIを動かせるようになりました。この記事では、何ができるのか、どんなPCが必要なのかをわかりやすく解説します。
Antigravity SDKがローカルAIに対応|発表の概要
2026年9月23日、Googleは開発者向けブログで大きなアップデートを発表しました。
Antigravity SDKが、ローカルAIモデル(自分のPCの中で動くAI)に正式対応したのです。
Antigravity SDKは、AIエージェント(指示を受けて自分で作業を進めるAI)を作るための道具です。ファイルを読む、書き換える、コマンドを実行するといった作業を、AIに任せられます。
これまでは基本的に、Googleのクラウド上にあるGeminiを呼び出して動かす仕組みでした。今回のアップデートで、頭脳の部分をPCの中のAIに置き換えられるようになります。
発表したのは、GoogleのグループプロダクトマネージャーSachin Kotwani氏と、プリンシパルエンジニアのTaylor Mullen氏です。なお、SDK自体はまだ「リサーチプレビュー(試験公開の段階)」という位置づけです。
何ができる?4つのメリットと仕組み
オフラインで動くAIエージェント
一番の変化は、インターネットにつながっていなくてもエージェントが動くことです。
Googleは、メリットとして次の4つを挙げています。
- コスト:API料金(使った分だけ払う利用料)も回数制限もかからない
- プライバシー:コードやデータがPCの外に出ない
- オフライン耐性:飛行機の中や通信が不安定な場所でも作業できる
- ハイブリッド:クラウドとローカルを組み合わせて使える
2つの接続方法
接続方法は2通り用意されています。
1つ目は「LiteRTAgentConfig」です。GoogleのAI実行エンジン「LiteRT」で、モデルを直接PC上で動かします。Apple製チップのGPUやNVIDIAのGPU、NPU(AI専用の計算チップ)を自動で見つけて使ってくれます。
2つ目は「LocalOpenAIAgentConfig」です。こちらはOllamaやLM Studio、vLLMといった、すでに広く使われているローカルAIツールにつなぐ方法です。
すでにOllamaでAIを動かしている人なら、接続先のアドレスを書き換えるだけで試せます。ハードルはかなり低いと言えるでしょう。
主役のGemma 4 26B A4Bとは
最初の対応モデルとして選ばれたのが「Gemma 4 26B A4B」です。Googleが無料で公開しているオープンモデル(誰でもダウンロードして使えるAI)の一つです。
名前の「26B」は、全体で約252億個のパラメータ(AIの知識をためる目盛りのようなもの)を持つという意味です。
一方の「A4B」は、1回の計算で実際に使うのが約38億個だけ、という意味です。これはMoE(専門家の混合)と呼ばれる仕組みです。
MoEは、大きな病院にたとえるとわかりやすいかもしれません。患者が来るたびに全員の医師が集まるのではなく、症状に合った専門医だけが診察します。だから大きなモデルなのに、動きは小さなモデル並みに軽いのです。
ほかにも、次のような特徴があります。
- 一度に読める文章の長さは最大25万6000トークン
- 文章だけでなく画像も読み込める
- 関数呼び出し(外部ツールを使う機能)に対応
- Apache 2.0ライセンスで、商用利用も自由
ダウンロードサイズは約16.8GBです。公式ドキュメントでは、Antigravity SDKで使う場合は64K(約6万4000トークン)程度の文脈サイズが推奨されています。
処理の97%をPC内で|ハイブリッド構成のデモ
Googleが見せたデモで特に注目されたのが、クラウドとローカルを組み合わせた「ハイブリッド構成」です。
役割分担はこうです。クラウド側のGemini 3.8 Flashが「設計担当」として作業の段取りを決めます。実際の作業は、PCの中にいる複数のGemma 4がこなします。
デモの内容は、プログラムの脆弱性(セキュリティの穴)を見つけて直す作業でした。ローカルのGemma 4たちが、穴を再現し、修正案を書き、互いの修正を批判し、テストで確かめるという流れを繰り返しました。
結果は驚くべきものでした。全体の97.2%にあたる3,322トークンがPCの中だけで処理されたのです。
クラウドのGeminiが使ったのは、わずか95トークンでした。しかもGeminiが見たのはファイル名と作業の説明だけで、ソースコード本体は一度もPCの外に出ていません。
いわば、現場監督だけを外部から呼び、職人はすべて自社の社員でまかなうような形です。コストと秘密保持の両方を守れる点が、このハイブリッド構成の強みです。
こんな場面で役立つ|3つの活用シーン
社外秘のコードを扱う開発チーム
ある金融系の開発チームを想像してみてください。社内ルールで、顧客データに関わるコードを外部のAIサービスに送ることが禁止されています。
これまでは、AIエージェントの便利さを横目で見ているしかありませんでした。ローカルモデルなら、コードがPCの外に出ないため、ルールを守ったままテストコードの下書きやバグ探しを任せられます。
出張中の新幹線で作業するエンジニア
東京から大阪へ向かう新幹線の中で、トンネルのたびに通信が途切れた経験はありませんか?
クラウド型のAIだと、そのたびに作業が止まってしまいます。ローカルモデルなら、電波がなくてもエージェントがコードの整形や単体テストの作成を続けてくれます。
API代に悩む個人開発者
週末にアプリを作っている個人開発者を考えてみましょう。AIエージェントを一晩中動かして細かい修正を繰り返させると、翌朝の請求額に青ざめることがあります。
単純な繰り返し作業はローカルのGemma 4に任せ、難しい判断だけクラウドに聞く。こうした使い分けで、毎月の費用を大きく抑えられる可能性があります。
競合ツールとの比較
AIエージェントを作る道具は、ほかにもいくつかあります。主なものと比べてみましょう。
- Antigravity SDK(Google):Gemini中心だが、今回ローカルモデルに公式対応。LiteRTで直接動かせるのが独自の強み
- OpenAI Agents SDK:OpenAI互換のAPIを通じてほかのモデルにもつなげられると言われていますが、基本はクラウドのGPTシリーズが前提
- Claude Agent SDK(Anthropic):Claudeモデル専用の設計で、クラウド利用が基本
- Ollama・LM Studio:ローカルAIを動かすための道具。エージェント機能そのものは持たないため、Antigravity SDKと組み合わせて使う関係です
大きな違いは、「モデルを作る会社」が自社SDKでローカル実行を正式にサポートした点です。Googleはクラウドの売上を持ちながら、あえてAPIを使わない道も用意しました。
もちろん課題もあります。ローカルモデルの実力は、長く複雑な作業ではクラウドの最上位モデルに及ばないと見られています。Antigravityと組み合わせた場合の独立した性能評価も、まだ公開されていません。
日本のユーザー・企業への影響
日本の開発者にとって、このアップデートはどんな意味があるのでしょうか。
まず、情報を社外に出せない業界での導入が進みやすくなります。金融、医療、行政、製造業の設計部門などでは、クラウドAIの利用に慎重な組織がまだ多いのが実情です。PCの中だけで完結するなら、社内の審査も通しやすくなるでしょう。
次に、ハードウェアの問題です。推奨は24GB以上のGPUメモリ、またはユニファイドメモリ(CPUとGPUが共有するメモリ)です。
一般的な事務用ノートPCは8〜16GBが多いため、そのままでは足りません。メモリを多めに積んだMacや、大容量のGPUを載せたPCが必要になります。
当サイトでも、Mac StudioでAIを自作した院長の事例を紹介しました。こうした「手元にAIマシンを置く」流れが、エージェントの分野にも広がりそうです。
日本語への対応については、Gemma 4は多言語に対応したモデルです。ただ、日本語での長いエージェント作業の精度は、実際に試して確かめるのが安心です。
よくある質問(FAQ)
Q1. 本当に料金はゼロですか?
ローカルで動かす分には、API料金はかかりません。ただし、PC本体の購入費や電気代は必要です。ハイブリッド構成でGeminiを使う場合は、その分の料金がかかります。
Q2. 普通のノートPCでも動きますか?
Gemma 4 26B A4Bは、24GB以上のメモリが推奨されています。メモリが足りないPCでは、より小さなGemma 4(E2Bなど)をOllama経由で使う方法も紹介されています。ただし、小さいモデルほど賢さは下がります。
Q3. どのプログラミング言語で使えますか?
公式のPython版(v0.1.18)に加えて、Java版(v0.2.17)も同じ機能に対応しました。Windows、macOS、Linuxの計6種類の環境で動く実行ファイルが用意されています。
Q4. Gemma以外のモデルも使えますか?
使えます。OllamaやLM Studio、vLLMにつなぐ方法なら、そこで動くほかのオープンモデルも選べます。ただし、公式に最適化されているのは今のところGemma 4 26B A4Bです。
Q5. 会社で使っても問題ありませんか?
Gemma 4はApache 2.0ライセンスなので、商用利用も可能です。ただしSDKはまだ試験公開の段階なので、仕様が変わる可能性がある点には注意しましょう。
まとめ
- Antigravity SDKが2026年9月23日にローカルAIモデルへ正式対応した
- 最初の対応モデルはGemma 4 26B A4B。約16.8GBで、24GB以上のメモリが推奨
- Ollama・LM Studio・vLLMにもつなげられる
- ハイブリッド構成のデモでは、処理の97.2%をPC内で完了
- 社外秘のデータを扱う企業や、API代を抑えたい個人に向いている
まずは手元のPCのメモリ容量を確認し、Ollamaで小さなGemma 4から試してみるのがおすすめです。
参考文献
- Introducing Support for Local AI Models in the Antigravity SDK(Google Developers Blog)
- Local models(Google Antigravity Docs)
- Running Agents Powered by Local Gemma Models with LiteRT-LM and the Antigravity Java SDK(Guillaume Laforge)
- google/gemma-4-26B-A4B-it(Hugging Face)
- Google Antigravity SDK Local Models Bring Agents Offline, but Hardware Sets the Boundary(remio)